2026-11-14 更新: 本文依 emfor 0.4.0 修訂。0.4.0 起,非負責主機至少每三個
interval自己檢查一次(0.3.0 是每五個),自己的檢查失敗時會開始快速複查;聯防訊息也改為加密。詳見 emfor 0.4.0 的發佈說明。
一、emfor 是什麼
emfor 是一個開源、跑在每一台應用程式主機上的健康檢查 daemon。它定期檢查應用程式所用服務的 backend(TCP、HTTP、Nagios 風格的 script,以及 redis、MySQL、PostgreSQL、LDAP 等 plugin),把哪些 backend 健康寫進同一台主機上的 LMDB 檔案。應用程式要連資料庫時,向 client 函式庫要一個位址;函式庫讀本機檔案、依設定的 balance 挑出 10.0.3.1:5432 這樣的答案。
              checks over the network
  backends <------------------------------ emfor daemon ---------> DNS on 127.0.0.1
                                               |  writes
                                               v
                                     local LMDB state store
                                               |  reads
                                       client library
這個設計的重點是:查詢不經過網路。一次查詢大約一微秒,其他主機或網路出問題時照樣能用。每台主機用自己的設定、從自己的位置看 backend,沒有中央伺服器。
但「每台各自看」也有代價。
二、每台各自檢查的三個問題
1. 發現得慢。 backend 要連續失敗 fall 次才會被標成不健康。預設 interval = 2s、fall = 3,大約 6 秒。同一個機房裡有二十台主機,每一台都要自己花這 6 秒,而它們看的其實是同一台壞掉的 backend。
2. 本機看到的不一定是真相。 一台主機的檢查失敗,可能是 backend 真的掛了,也可能只是這台主機的網路、防火牆規則或負載出了問題。反過來,一台主機連得上,也不代表其他主機都連得上。單一主機無從分辨。
3. 檢查量隨主機數成長。 N 台主機、每台都檢查每個 backend,backend 每個 interval 就要回應 N 次檢查。主機一多,健康檢查本身就成了 backend 的負擔。
聯防群組(peer group)就是為這三件事設計的。
三、聯防群組做了什麼
同一個機房(site)的 emfor daemon 在設定檔的 [peers] 裡列出彼此,就組成一個聯防群組。成員之間用經過簽章的 UDP 訊息溝通,做三件事。
1. 故障通知:別人發現了,我馬上複查
每個成員每秒送一次 heartbeat,讓大家知道誰還活著。當某個成員看到 backend 從 healthy 變成 unhealthy,它通知其他所有成員。收到通知的成員不會直接相信,而是立刻自己重新檢查那個 backend,之後每 200 ms 一次、最多 fall 次,而不是等到下一個 interval。
結果是:只要有一個成員發現故障,其他成員大約一秒內就會用自己的檢查確認並跟上。通知只是「該看一下了」的提示,從不直接改變 backend 的狀態。
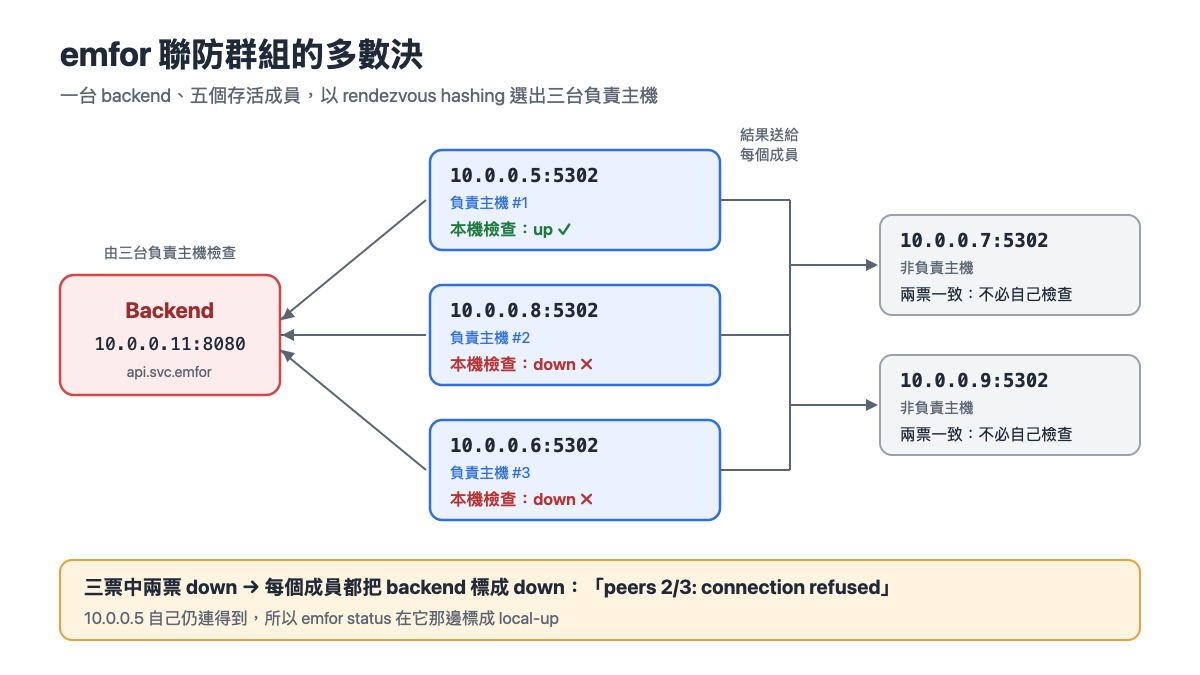
2. 多數決:三台負責主機投票
真正會改變狀態的是投票。存活成員(含本機)有三台以上時,每個 backend 有三台負責主機(assigned checker)。負責主機的挑法是 rendezvous hashing:對每個候選成員計算
MD5("<服務名稱>/<backend>/<成員位址>") 的前 4 bytes
取數值最大的三台。因為每個成員都用同一個公式、看同一份存活名單,不需要任何協調,大家就會挑出同樣的三台;成員加入或離開時,也只有少數 backend 的負責主機會變動。
負責主機每次自己檢查後,把結果(up 或 down)送給其他成員。每個成員每次檢查後,計算這個 backend 負責主機送來、夠新、而且檢查定義相同的票:
| 票的情況 | 結果 | 原因的寫法 |
|---|---|---|
兩票以上 down | 判為 down,即使本機檢查通過 | peers 2/3: connect: Connection refused |
不到兩票 down,本機檢查失敗 | 以本機結果為準 | local: connect: Connection refused |
| 存活成員不到三台,或一票都沒有 | 本機結果原樣使用 | 原本的原因,沒有前綴 |
原因的前綴讓維運人員一眼看出判斷從哪裡來:peers 2/3: 是群組的共識,local: 是只有這台主機看到的問題。後者特別值得注意,它通常代表這台主機自己的網路或防火牆有狀況。
反過來的情況也看得到:群組判為 down、但本機檢查通過的 backend,emfor status 會標上 local-up,emfor_peer_disagreements 會計數。這種「我連得到、別人連不到」的不一致,往往是網路分割或其他主機上防火牆規則的訊號。
「檢查定義相同」也很重要。每個服務的 check、check_options 與 timeout 會算成一個 digest,只有 digest 相同的成員,票才會被計入。兩台主機對同一個服務用不同的檢查方式時,它們的結果不能直接比較,emfor 會在 emfor status 顯示「check definition differs」,提醒把設定改成一致。
3. 分工:不是負責主機就少檢查
有了投票,非負責主機就不必每次都自己檢查。兩台負責主機意見一致時(兩票 up 或兩票 down),非負責主機直接採用投票結果,跳過這次檢查。但它不會完全放手:
- 至少每三個
interval一定自己檢查一次; - 一致的票少於兩張時,每次都自己檢查;
- 自己的檢查失敗、但負責主機都說 up 時,像收到
down通知一樣,開始每 200 ms 一次、最多fall次的快速複查; - 本機上次檢查失敗時,恢復每個
interval都檢查,直到通過; - 投票說 up、但本機還沒有量到延遲時,自己檢查一次,確保不會在沒有實測的情況下把 backend 判為健康。
有三台負責主機、N 個成員時,每個 backend 每個 interval 大約被檢查
3 + (N − 3) / 3 次
而不是 N 次。以 20 台主機為例,從每個 interval 20 次降到約 8.7 次。
代價是:只有某一台非負責主機看得到的故障(例如只影響這台主機的路由問題),要等到它下一次自己檢查,再加上快速複查才會發現。以 interval = "2s"、fall = 3 實測 12 次故障,花了 0.8 到 5.8 秒,中位數 3.3 秒;0.3.0 每五個 interval 才自己檢查、也沒有快速複查,最長約 14 秒。這是用檢查量換取的延遲,emfor status 會把這類 backend 標上 voted,讓維運人員知道這台主機上哪些 backend 主要靠投票判斷。
四、設計上守住的幾條線
聯防群組加進來之後,emfor 原本的幾個性質都沒有改變:
- 查詢仍然只讀本機 store。 群組交換的資料只影響 daemon 怎麼判斷,client 函式庫完全不知道群組存在,查詢也不會因此多一次網路往返。
- 連不到成員時退回本機判斷。 成員停了、網路斷了,投票自然沒有票,daemon 就回到完全依自己檢查的模式,和沒有群組時一樣。
- 沒有 master,也不跨機房。 每個成員地位相同,負責主機由雜湊決定,不需要選舉。群組限定同一個
site,因為不同機房看到的網路本來就不同,不應該互相投票。 - 訊息要加密、要防重放。 每則訊息以從共用密鑰推導的金鑰做 ChaCha20-Poly1305 加密(0.3.0 只有 HMAC-SHA256 簽章、內容是明文),接收端檢查來源位址必須是成員、時間戳與本機時鐘相差不超過 5 秒,並拒絕重送的舊訊息。密鑰可以不停機更換:主機發現自己的密鑰檔改變後,仍用舊密鑰送 60 秒、接受舊密鑰 120 秒。
五、怎麼設定
在同一個機房的每台主機加上:
site = "dc1"                               # 有 [peers] 時必填

[peers]
listen = "10.0.0.5:5302"                   # 這台主機在群組裡的位址
members = ["10.0.0.5:5302", "10.0.0.6:5302", "10.0.0.7:5302"]
secret_file = "/etc/emfor/peers.key"       # 至少 32 bytes,權限 600 或 640
members 列出每個成員(包含自己),同一份清單可以放在機房裡的每台主機上,只有 listen 不同。投票與分工沒有額外的設定,直接用各服務原本的 interval。
某些服務不適合聯防,例如檢查結果本來就因主機而異。可以讓個別服務不參加:
[services."local-cache.svc.emfor"]
check = "tcp"
backends = ["127.0.0.1:11211"]
peers = false
設了 peers = false 的服務在這台主機上不送通知、不送結果、忽略收到的訊息,一律依自己的檢查判斷;其他服務照常聯防。改這個設定只要 reload,backend 的狀態會保留。這台主機會在 heartbeat 裡告訴其他成員它讓哪些服務不參加(每個服務名稱的短雜湊),其他成員挑這些服務的負責主機時就不會算它;只要存活成員夠多,這些 backend 仍有三台會投票的負責主機。所以每台主機可以各自決定哪些服務不參加。聯防群組與這項宣告都是 emfor 0.3.0 加入的,群組裡的每個成員都會讀這項宣告。
六、看得到群組在做什麼
emfor status 在 daemon 那一行下面顯示群組狀態:
peers: 4/4 live, checks 12/40 backends here
peers: check definition of api.svc.emfor differs at 10.0.0.6:5302
第一行說明成員存活狀況,以及顯示的 40 個 backend 中,有 12 個是這台主機每次都自己檢查的(其餘的標 voted)。emfor status --json 還會列出每個 backend 的負責主機:
"assigned_checkers": [
  {"service": "api.svc.emfor", "backend": "10.0.0.11:8080",
   "checkers": ["10.0.0.5:5302", "10.0.0.8:5302", "10.0.0.6:5302"]}
]
Prometheus 方面,emfor_peer_up 看成員存活、emfor_peer_messages_rejected_total 看被丟棄的訊息與原因(auth 是密鑰不同、stale 是時鐘偏移、sender 是成員清單不符)、emfor_peer_disagreements 看不一致的 backend、emfor_peer_checks_skipped_total 看分工省下多少檢查。
七、小結
聯防群組沒有把 emfor 變成一個分散式系統,它更像是讓同一個機房的 daemon「互相提醒」:
- 一台發現故障,其他台約一秒內複查跟上;
- 三台負責主機投票,分辨「backend 真的掛了」與「只是我這台有問題」;
- 非負責主機靠投票省下大部分檢查,backend 的檢查量不再隨主機數線性成長。
而查詢依然只讀本機檔案、依然在微秒內完成,群組裡任何成員出事,最壞的情況也只是退回每台各自判斷。
emfor 的原始碼、完整手冊與設定範例都在 GitHub:github.com/embark-systems/emfor。
💡 技術協作與架構諮詢
您的服務是否也面臨健康檢查不一致、故障發現太慢,或檢查流量壓垮 backend 的問題? 我們能協助您評估架構、導入合適的健康檢查與服務發現機制。