emfor 是一個開源、跑在每一台應用程式主機上的健康檢查 daemon:它檢查應用程式所用服務的 backend,把哪些 backend 健康寫進本機的檔案,應用程式透過 client 函式庫在大約一微秒內查到該連哪一台,不經過網路。
0.6.0 在 2026-11-17 發佈。0.5.0 談的是 daemon 周圍出狀況時會怎樣;這一版談的是和你已經有的東西一起用:部署時把 backend 拿出來、把設定拆成多個檔案、問 emfor 應用程式會拿到什麼以及為什麼,並把它的 DNS 答案接到 nginx、HAProxy、Caddy、Prometheus、pf,以及自己查 SRV 記錄的 client。這一版也提供 deb 與 rpm 套件,手冊多了一章給從 HAProxy 或 Consul 搬過來的人。
一、升級前先看
store 格式(版本 2)與 plugin 協定(1)沒有改:0.5.0 的 client 與 plugin 仍能搭配這一版的 daemon,0.5.0 接受的設定也仍然接受。仍有三件事可能影響現有環境:
- 要用
drain = true,請先升級libemfor與各 client。 被 drain 的 backend 在 store 裡寫成unhealthy,舊 client 會像對待任何不健康的 backend 一樣略過它。例外是open服務在全部 backend 都掛掉時的最後一層:那裡舊 client 仍可能選到它。 [peers]的secret_file如果群組或其他人可寫,現在會被拒絕,含密碼的檔案本來就該如此。有這種檔案的群組,升級後會載入不了設定:emfor check-config會先發現。(新的include_dir裡的檔案同樣不可讓群組或其他人寫入,擁有者也必須是 root 或執行 emfor 的使用者;請用那個使用者執行emfor check-config。)libemfor改名為 0.6(libemfor.so.0.6),FreeBSD 的範例 port 也從examples/freebsd/搬到packages/freebsd/(檔案相同):有連結或腳本寫著舊路徑的要更新。
二、drain = true:部署時把 backend 拿出來
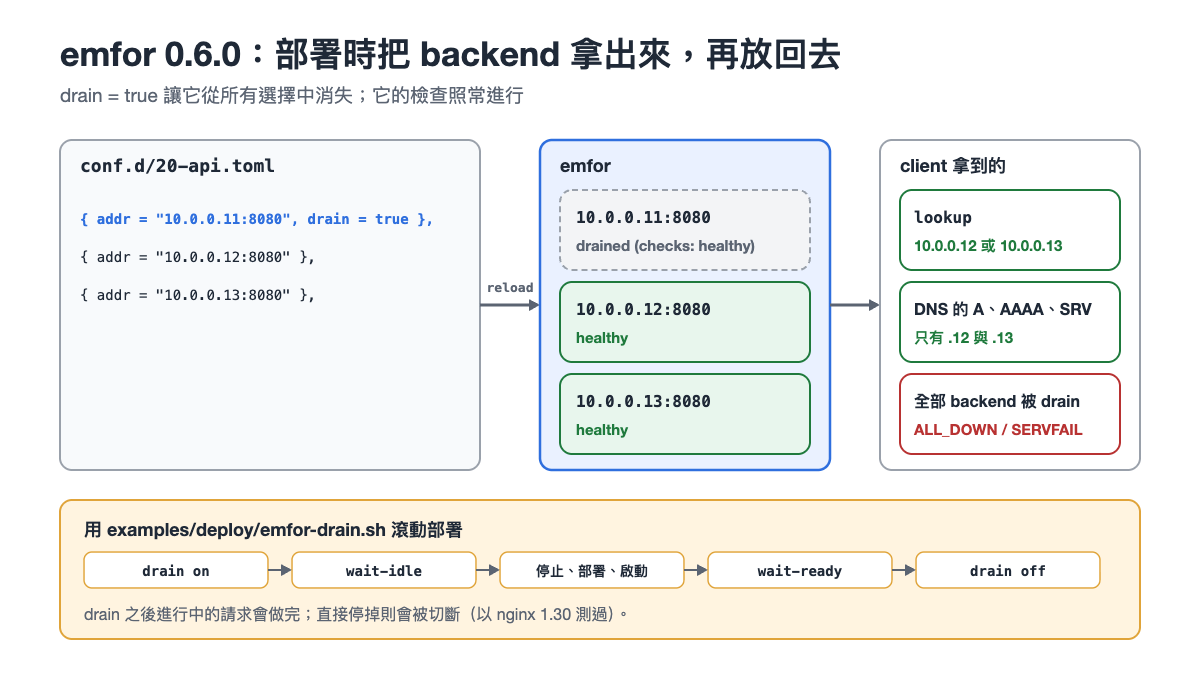
backend 的表可以設 drain = true。reload 之後,這個 backend 不會被任何選擇方式選到:沒有 balance 方法會選它(含 sticky 與 failover),DNS 的 A、AAAA 與 SRV 答案裡沒有它,fastest 的池裡也沒有。它的檢查照常進行,所以 emfor status 顯示 drained (checks: healthy),拿掉 drain 後它立刻回來,狀態就是檢查給的,不必重新數 rise。emfor lookup --explain 把它列為 drained,指標 emfor_backend_drain 對它是 1。
一個服務的 backend 全部被 drain 時,lookup 會失敗並回 ALL_DOWN,DNS 回 SERVFAIL,不論是否 open。drain 屬於這台主機:不會傳給其他成員,也不算進成員之間比對的服務定義。沒有執行期的指令:改設定檔再 reload。
手冊第 8 章有一個圍繞它的滾動部署食譜,examples/deploy/emfor-drain.sh 做一台 backend 的這幾步:在 conf.d 的檔案裡設 drain、檢查設定、reload、等到 emfor 顯示它被 drain,之後等它的檢查通過才放回去。前面是 nginx 時,drain 之後進行中的請求會做完,直接停掉則會被切斷。wait-ready 不相信第一個 healthy:剛停掉的 backend 會維持那個狀態 fall x interval(預設 6 秒),所以它要等一次比指令更新的檢查,並且連續 10 秒都是 healthy。
三、設定拆成多個檔案,與 check-config --show
在 emfor.toml 裡寫 include_dir = "conf.d",daemon 會先讀主設定檔,再依檔名順序讀該目錄裡每個 *.toml 檔(位元組順序:請寫 01-、10-、99-),後面的檔案蓋掉前面的。表是一個鍵一個鍵合併;其他東西,包括 backends 這種清單,整個被後面的值取代。後面的檔案不能刪掉前面定義的服務或 backend。[store] 與 include_dir 只在主設定檔有效,因為 emfor status 與 emfor lookup 只讀那個檔。
目錄必須存在,否則設定被拒絕(啟動時 daemon 以 2 結束;reload 時保留舊設定)。錯誤訊息會帶出檔名,emfor check-config 會列出它讀過的檔案,daemon 在啟動與 reload 時把清單寫進 log。下面的套件附的設定只有 include_dir = "conf.d",加上一個空目錄。
emfor check-config --show 和以前一樣檢查設定,並把合併後的設定以 TOML 印到標準輸出,每個值後面加 # <檔案>,是最後設定它的那個檔。內建預設值不會補上,也不遮蔽任何東西。這個註解格式給人看,不是給腳本用;不加 --show 時沒有任何改變。
四、emfor lookup,與更清楚的 emfor status
emfor lookup <服務> [--key <k>] [--explain] [--json] [--dns A|AAAA] 印出 client 函式庫會給的 backend,給沒有 client 的 shell 腳本與 cron 用。--explain 顯示 store 是否過期、候選來自哪一層、其他每個 backend 被排除的原因(unhealthy、unknown、last check failed、backup held back、not in the pool、not at this site、stale)、slow start 的步驟,以及 balance 怎麼選,而且不會推進任何輪替。--dns A|AAAA 從 store 說明 DNS 伺服器的答案。--json 只會增加欄位;結束碼 0 是有答案、1 沒有 backend、2 沒有這個服務或用法錯誤、3 store 不能用。
emfor status 的文字輸出現在會標出 backup backend,標出仍是 healthy 但最近一次檢查失敗的 backend(last check failed,lookup 通常會略過它),而且當群組的存活成員少於三個時,peers: 那一行會寫 too few live members to vote,表示每個原因都只是這台主機自己的。
五、接上你已經在用的工具的食譜
手冊第 7 章現在分成兩章:DNS 參考,與第 7b 章的食譜。每個食譜都有一支測試腳本,在容器裡對真正的程式跑(tests/<名稱>/run.sh);Integrations workflow 每週跑其中大部分,pf 那支則是在 FreeBSD 上手動跑過。測試找到、手冊現在寫明的事:
- nginx(1.27.3 或更新):
server api.svc.emfor service=http resolve;配resolver 127.0.0.1:5300,從 emfor 的 SRV 答案取得 upstream;健康狀態、drain與權重在幾秒內送到,不必 reload。stream也能用。查詢失敗之後,nginx 要等resolver_timeout才會再問,預設 30 秒,所以食譜設resolver_timeout 1s。 - HAProxy:用
server-template從 SRV 答案填入 server。HAProxy 會忽略 SRV 的優先順序與權重,所以failover、weighted、locality與fastest的表現和 nginx 不同;SERVFAIL之後它會在hold other(30 秒)後丟掉 server,nginx 則保留最後一份清單;對 backend 用 TLS 時要設sni。 - Caddy:
reverse_proxy搭配dynamic srv。dynamic srv與transport http兩處都要resolvers,還要grace_period(沒有它,emfor 回SERVFAIL時每個請求都失敗)與lb_try_duration(沒有它,剛停掉的 backend 會掉請求);只有lb_policy first才依優先順序。 - Prometheus:
dns_sd_configs的SRV類型把健康的 backend 變成抓取目標。檢查失敗的 backend 不再是目標,所以它的up序列直接結束,up == 0永遠不會觸發:請改用 emfor 自己的指標告警。 - pf(FreeBSD):
examples/pf/emfor-pf-table.sh讓 pf 的 table 等於優先順序最低的 SRV 目標,於是一條rdr規則就把連線分散到 emfor 提供的 backend,不需要 proxy。 - 自己查 SRV 記錄的 client:MIT Kerberos(
dns_lookup_kdc)、OpenLDAP(ldapsearch -H 'ldap:///dc=ldap%2Cdc=svc%2Cdc=emfor',逗號必須寫成%2C)與 PyMongo(mongodb+srv://)透過 emfor 找到伺服器,並避開檢查失敗或被 drain 的伺服器。 - Nagios、Icinga 與 Zabbix:
examples/nagios/check_emfor.sh把emfor status --json報告的內容轉成 Nagios 狀態,examples/nagios/emfor-exec.sh則把現成的 Nagios plugin 當成exec檢查來跑。
每一節結尾都寫了沒試過什麼(真正的 KDC、LDAP 與 MongoDB 伺服器、nginx Plus、HTTPS upstream 等);採用某個食譜之前請先讀那一段。第 10 章是新的:它把 HAProxy 的 backend 與帶 HTTP 檢查的 Consul 服務,一個選項一個選項地翻成 emfor.toml,說明哪些沒有對應(最少連線、重試、被動檢查、註冊),並說明怎麼在現有環境旁邊試用 emfor。
六、deb 與 rpm 套件
packages/build.sh 在一個用舊 glibc 的容器裡建出 deb 與 rpm(Debian 11 以後、Ubuntu 20.04 以後、RHEL 9 及相近的發行版):/usr/bin 下的 emfor 與 emfor-check、systemd unit、範例設定,以及 emfor 使用者(deb 會啟用並啟動服務,rpm 不會)。它們由這個 repository 建出,沒有發佈,也沒有簽章。它們依賴 ca-certificates:http 檢查即使 scheme = "http" 也用系統的根憑證建 client,沒有就會失敗。
七、全系統審查的修正
對整個系統對照程式碼與測試所做的審查,找到並修正了:
- reload 或結束時,被取消的 plugin 請求不再算成「沒有答案」,所以由多個服務共用的健康 plugin,不會在其中一個服務被 reload 掉時被殺掉重啟;
emfor check-config與emfor lookup遇到寫入標準輸出的錯誤,會回報錯誤與結束碼,不再 panic;管線被關掉不算錯誤;- plugin 的
validate答案有大小上限,被拒絕的 reload 不會讓 daemon 殺掉正在跑的 plugin; - 聯防群組訊息裡的
boot必須是規格所寫的小寫十六進位;成員的down原因在寫進 log 前會被截短並跳脫;DNS 的速率限制在表滿時每秒清一次,不再每個封包清一次。
手冊第 7、8、10 章中,說得比測試所能證明的更多的地方也已更正。刻意不改的:RADIUS 的 secret_file、password_file 與 tls_key_file 仍然沒有權限檢查,因為加上去會讓目前能跑的安裝起不來。
八、已知限制
- FreeBSD 只在 15.1-RELEASE(arm64,VM)測過:測試、rc.d 腳本、用
make stage check-plist檢查的 port、fork 測試,以及手動跑過的 nginx、HAProxy 與 pf 食譜。沒測:poudriere、13.x、14.x、amd64。 - HAProxy 3.4.4 在 FreeBSD 上,
server-template的某個位置曾出現「位址對、port 為 0」,之後有一段時間回 503,只用一個 name server 時也會;原因不明,同一個測試在 Linux 上通過。 - deb 與 rpm 在沒有 systemd 的容器(arm64)裡安裝、升級與移除過(deb 也在 systemd 下試過);沒在 x86-64 上測,rpm 也沒在 systemd 下測,且沒有簽章、沒有發佈。
- 與先前版本相同:聯防群組的訊息沒有 forward secrecy;
ldapplugin 只對 Active Directory 檢查過,而且沒有憑證;Linux 上跨執行緒的 lookup 吞吐量在每秒約兩百萬次時趨平;[store] sync = false(預設)時,主機當機可能損壞 store;一台主機最多對聯防群組宣告 80 個被排除的服務。
九、怎麼升級
- 升級前,用 daemon 的使用者與 0.6.0 的二進位檔,對每台主機的設定跑
emfor check-config(見第一節)。 - 一台一台安裝 0.6.0 的
libemfor與 daemon;打算用drain = true的話,先升級 client。 - 要用新東西:加上
include_dir並把服務搬進檔案、在一台主機上試emfor lookup --explain,再讀第 7b 章裡你用的 proxy 或工具。
本站的使用者手冊已更新到 0.6.0。完整的變更清單在 CHANGELOG,原始碼與發佈在 GitHub 的 v0.6.0 release。
💡 技術合作與架構諮詢
您的服務是否也面臨健康檢查不一致、故障發現太慢,或檢查流量壓垮 backend 的問題? 我們能協助您評估架構、導入合適的健康檢查與服務發現機制。