emfor 是一個開源、跑在每一台應用程式主機上的健康檢查 daemon:它檢查應用程式所用服務的 backend,把哪些 backend 健康寫進本機的檔案,應用程式透過 client 函式庫在大約一微秒內查到該連哪一台,不經過網路。
0.5.0 在 2026-11-15 發佈。0.4.0 改的是應用程式拿到哪一個 backend;這一版談的是周圍出狀況時會怎樣:store 被斷電截短、plugin 不再回應、磁碟 commit 很慢、任何人都連得到的 DNS port、FreeBSD 上 fork 出來就卡住的子行程。另外,聯防群組多了第二種加密格式,emfor check-config 也會拒絕更多一定跑不起來的選項。
一、升級前先看:三件可能影響現有環境的事
1. 0.4.0 接受的設定,現在可能被拒絕。 emfor check-config(每次啟動與 reload 都會跑)會拒絕一些一定無法運作、0.4.0 卻放行、之後才出錯的選項。最可能遇到的:
interval超過24h,或timeout小於10ms;- http 的
host_header不是「主機名稱加選用的 port」(含空白、路徑或 scheme),或 http 的path含#、\或控制字元; - 啟用
[dns]時,服務名稱長到容不下其 backend 的 SRV 目標名稱; - exec 或 plugin 的
command含 NUL,或ca_file裡沒有任何可當 CA 的憑證; emfor-check方面:mysql、pgsql、amqp 的帳號或密碼含 NUL、amqp 密碼長到塞不進 AMQP 的第一個 frame、diameter 的選項清單長到一則訊息放不下、sip 的uri或from含<或>、mongodb 的password_file內容不是可印出的 ASCII。
升級每一台主機之前,先用新的 binary 對它的設定跑 emfor check-config。
2. DNS 伺服器依 client 網段限制 UDP 回應數。 預設每個 IPv4 /24(IPv6 /56)每秒 100 個回應([dns] rate_limit,設 0 關閉)。SRV 的回應可能是查詢的許多倍大,其他主機連得到的伺服器,可能被拿來用偽造來源位址的查詢灌第三方。超過上限後,每隔一個回應會回一個空的截斷回應,讓真正的 client 改走 TCP 重試,其餘丟棄,並計入 emfor_dns_rate_limited_total。loopback 的 client 與 TCP 不受限。如果轉送你的 zone 的 resolver 從同一網段每秒送超過 100 個查詢,請調高上限。啟動時,daemon 也會對每個不是 loopback 的 [dns] listen 位址記一則警告。
3. libemfor 的檔名跟著 0.5:libemfor.so.0.5 與 libemfor.0.5.dylib。和每個版本一樣,libemfor 要和 daemon 裝同一版;Python 套件會先找與自己同版號的檔案。
store 格式(第 2 版)與 plugin 協定(第 1 版)沒有變。
二、聯防群組
第二種加密格式 EMP3。 0.4.0 用 ChaCha20-Poly1305(EMP2)加密聯防訊息,每則訊息用隨機的 12 位元組 nonce。同一把 secret 下,約 2^32 則訊息以內是安全的;以估計(不是量測)來說,大型群組幾天內就可能送出這麼多則,nonce 一旦重複,旁觀者就能讀取並偽造訊息。EMP3 改用 XChaCha20-Poly1305,nonce 24 位元組隨機、金鑰另外衍生,實務上沒有上限。
格式依每個成員分別決定。0.5.0 送出的每則 EMP2 訊息,加密的內容裡都帶 "emp3": true;從某個成員收到的最新一則訊息若是 EMP3 或帶這個欄位的 EMP2,就改用 EMP3 傳給它,否則用 EMP2。所以 0.5.0 的成員彼此用 EMP3、和 0.4.0 的成員用 EMP2,群組可以任意順序升級或退回,不必改設定。退回 0.4.0 的主機,大約在最初一秒內會丟掉收到的 EMP3 訊息。EMP3 的位元組已和另一份獨立撰寫的實作核對過,那份實作本身通過 XChaCha20 草案的測試向量。
聯防群組的其他變更:
[peers] accept_plaintext = false會不檢查就丟掉所有未加密的EMP1訊息,計入新的原因plaintext;成員全都加密的群組,不必再接受簽章的明文。需要encrypt = true。- 新增
[peers] previous_secret_file:secret_file上一次更換之前的 secret。更換後 120 秒內重啟的 daemon,會像沒重啟一樣繼續用舊 secret 簽章與接受;以前,檔案還沒換的成員會把它當成auth拒絕。 - 第一次更換
secret_file後 60 秒內又換第二次,不再用還沒換檔的成員不認得的中間 secret 簽章一分鐘。 - 投票的修正。 成員會把另一個成員的最新結果保留 3 個「寄送者的 interval」,並在這段期間自己的每個檢查時間點都算一次。這裡
interval = "1s"、指派的檢查者是"30s"時,兩個檢查者各一個down,就可能讓fall被推進約 90 次,把檢查者自己還看到健康的 backend 標成 down。現在每個結果只在一個檢查時間點計算一次。 - 亂序到達的訊息會被接受一次,而不是當成
replay丟掉。
三、出狀況時仍然撐住
- store 被截短,不再以
SIGBUS結束行程。 store 檔案比 LMDB 記錄的短(原地被改,或尾端在斷電時遺失),啟動時會像其他損壞一樣被移到<path>.corrupt,並記一則寫著truncated的警告。以前,為了檢查而讀取它會讓 daemon 以SIGBUS結束,每次重啟都一樣。emfor status會印出cannot open store: truncated並以 2 結束,client 的查詢則回UNAVAILABLE,而不是讓應用程式死掉。daemon 現在每次 commit 後,會把檔案延伸到 LMDB 記錄的長度,所以健康的 store 不會被當成截短。開著時被原地改動的 store,仍可能讓執行中的 client 出這個問題:要換掉它請用mv,不要用cp覆蓋或truncate。 - 不再回應的 plugin 會被重啟。 以前只有結束或關閉 stdout 的 plugin 會被重啟;一個還在跑卻不回任何答案的 plugin,會讓它所有 backend 的檢查永遠是
error,對它的請求也無限堆積。現在,連續 3 個請求的呼叫端都放棄、期間沒有任何答案回來,daemon 就會記錄、殺掉並重啟這個 plugin。在timeout_ms內有回答的 plugin 不受影響。 - commit 很慢時,DNS 回答與
/metrics不再被凍結。 state store 等磁碟時,daemon 以前會停止套用檢查結果,DNS 因此持續回答舊的狀態。現在結果一到就套用,這段時間的變更由下一次 commit 一起寫入。 - 有上限的佇列。 落後超過 4096 則訊息的 peer task,會丟掉新的
down與result訊息(計入emfor_peer_queue_dropped_total);不再讀 stdin 的 plugin 最多累積 1024 個等待的請求,之後的檢查立刻回error,原因是plugin <name> busy。 - DNS。 TCP 最多服務 128 條連線,並關閉 5 秒內沒有查詢的連線;DNS 監聽停掉時,daemon 會記錄並以 70 結束,讓服務管理員重啟它(以前 DNS 會悄悄沒聲音);EDNS 版本大於 0 回 BADVERS,非 IN 的 class 回 REFUSED。
- store 裡單一個不是 UTF-8 的 key 或 value,不再讓 daemon 卡住;改了
interval的 reload 會套用到已在等待的那一次(以前從10m改成2s,最久要等 11 分鐘);daemon 以更大的[store] map_size重啟後,client 會繼續讀取。
四、emfor-check:遇到行為不正常的伺服器會卡住或當掉
我們對每個 plugin 用「回答錯誤的伺服器」做了一輪檢視,找到一批卡住與當掉的情形。現在全部都是帶原因的 down 或 error,並由檢查的 timeout 結束:
mongodb:要求 4294967295 次 SCRAM 迭代的伺服器,會讓一個工作執行緒忙上好幾分鐘(現在超過 1000000 就拒絕);巢狀約 8000 層的hello回覆會讓堆疊溢位、plugin 中止;- 走 TCP 或 TLS 的
sip:Content-Length 接近 64 位元最大值,會讓 plugin 對同一個暫時回應以滿載 CPU 無限迴圈; redis:超過 2 MiB 的回覆;mysql:SELECT 1回 NULL 會讓檢查 panic,被 timeout 截斷的檢查每次都會漏掉一個 task 和一個 socket;- 超過 512 字元的原因會在送出前截短:一個 70 KB 的 redis
-ERR讓回答行超過 daemon 的限制,於是每次檢查那個 backend,daemon 都重啟 plugin; - panic 的檢查會回
error與check panicked: <message>,而不是沒有回答。
mysql plugin 的實機測試(tests/plugins/mysql.sh)現在也對 MySQL 8.0 與 8.4 執行並通過;以前只檢查過 MariaDB。
五、Client,以及 FreeBSD 上的一個卡死問題
client 遇到被截短的 store 會讓查詢失敗、store 長大後會繼續讀取(見上),對存在但打不開的 store 最多每秒重試一次,並在 thread-local 解構函式裡呼叫 emfor_lookup 時回傳狀態碼而不是中止。新版 daemon 寫入的 backend state 或 on_all_down 值,不再讓查詢以 INCOMPATIBLE 失敗:未知的 state 視為 unhealthy,未知的 on_all_down 視為 open。
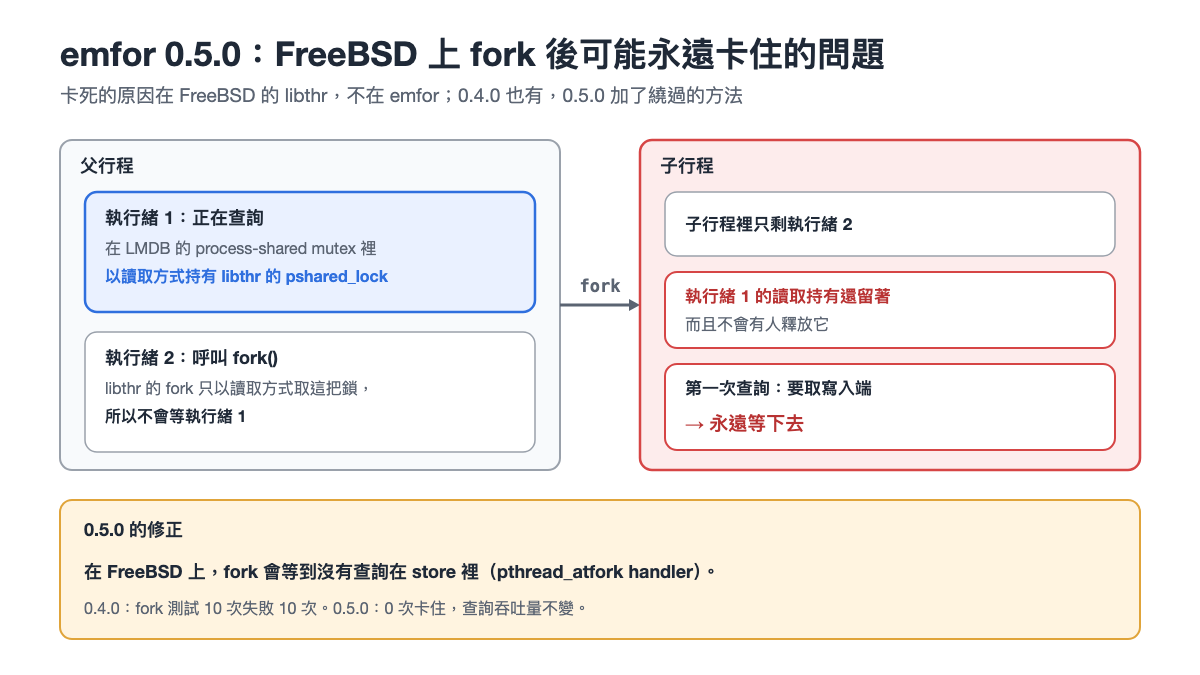
FreeBSD 上,fork 出的子行程可能永遠卡住。 我們的 fork 測試(其他執行緒在查詢的同時 fork)在 FreeBSD 15.1(arm64)上每次都失敗:子行程會在第一次查詢永遠等待,發生在 300 次 fork 的最初幾十次之內。0.4.0 在那裡有同樣的卡死:用同一組測試從它的 tag 建置,Rust 測試 10 次中失敗 10 次,C 測試 5 次中失敗 5 次。
原因在 FreeBSD 的執行緒函式庫 libthr,不在 emfor。LMDB 把 reader mutex 放在 store 的 lock 檔裡,是 process-shared mutex;libthr 在自己的一把鎖後面查這類 mutex,而它的 fork 只以讀取方式取得這把鎖,所以當時正在這類 mutex 裡的執行緒,其讀取持有會留在子行程裡,沒有人會釋放;子行程第一次使用新映射的 mutex 就會等它。在卡住的子行程上我們讀了那把鎖:一個讀者留著、一個寫者在等。libthr 在這之外還有第二個問題:父行程在另一個執行緒第一次映射 process-shared mutex 時 fork,可能死鎖。
client 現在在兩處都繞過這些問題:在 FreeBSD 上讓 fork 等到沒有查詢在 store 裡(pthread_atfork handler),而 libemfor 在那裡不能再被卸載,因為 handler 會留著。查詢吞吐量沒有變(以 1、4、8 個執行緒量測)。它不涵蓋同一行程裡其他使用 process-shared mutex 的程式、在信號處理函式裡 fork(而該信號打斷了同一個執行緒的查詢),以及靜態連結 libemfor.a 又會被卸載的模組。
我們也寫了一個 libthr 的 patch,連同一個不用 LMDB 的小型重現程式,放在 docs/freebsd/。我們用 15.1 的原始碼建置 libthr 兩次,未修補與修補各一:未修補時,5 次執行中每次 300 個子行程有 40 到 55 個卡住,死鎖的父行程永遠不會結束;修補後,5 次中沒有任何子行程卡住,父行程也能結束。沒有我們的繞過方式的 LMDB client,在修補過的函式庫上也能通過。我們只在 FreeBSD 15.1(arm64)上試過,也還沒有回報給 FreeBSD。
六、其他變更
emfor status:處理被截短的 store、emfor status | head -1保留結束碼、--watch在檔案被替換時重新開啟 store,以及顯示新版 daemon 的記錄而不是失敗。- 範例 systemd unit 設定
LimitNOFILE=65536。 - 發佈前每個 fuzz 目標各跑 10 分鐘。0.5.0 的六個目標(plugin 回答、peer 訊息、DNS 伺服器、metrics、plugin 協定與設定;其中 DNS 是新的)共跑約 1600 萬個輸入,沒有當機。它們現在開著 overflow 檢查,並讓每個輸入在 2 MiB 的堆疊上執行,和 tokio worker 一樣,所以溢位或遞迴過深就是當機,如同在 daemon 裡。
- 本站的使用手冊已更新到 0.5.0。
七、已知限制
- FreeBSD 只測過 15.1-RELEASE(arm64,在 VM 裡):測試、rc.d script、用
make stage check-plist install安裝 port,以及 fork 測試。沒有測過:poudriere、13.x、14.x、amd64。 - FreeBSD 的 fork 防護不涵蓋上面提到的情形,libthr 的 patch 也只在 15.1 上試過。
- 聯防訊息沒有 forward secrecy:之後取得
secret_file的人,可以讀取已錄下的訊息。請定期更換 secret。 ldapplugin 只對 Active Directory 在無憑證、也沒有成功登入的情況下檢查過。- 與先前版本相同:跨執行緒的查詢吞吐量在 Linux 上約每秒兩百萬次就趨平;
[store] sync = false(預設)時,主機當機可能損壞 store 並遺失狀態歷史;一台主機在聯防群組之外最多公告 80 個服務。
八、怎麼升級
- 升級每台主機之前,先用 0.5.0 的 binary 對它的設定跑
emfor check-config(第一節)。 - 逐台主機安裝 0.5.0 的
libemfor與 daemon。0.4.0 與 0.5.0 成員混合的聯防群組可以任意順序升級,[peers]不必改。 - 如果你的 DNS client 從同一網段送大量查詢,升級後請觀察
emfor_dns_rate_limited_total;如果它在增加,就調高[dns] rate_limit。
完整的變更清單在 CHANGELOG,原始碼與發佈在 GitHub 的 v0.5.0 release。
💡 技術合作與架構諮詢
您的服務是否也面臨健康檢查不一致、故障發現太慢,或檢查流量壓垮 backend 的問題? 我們能協助您評估架構、導入合適的健康檢查與服務發現機制。