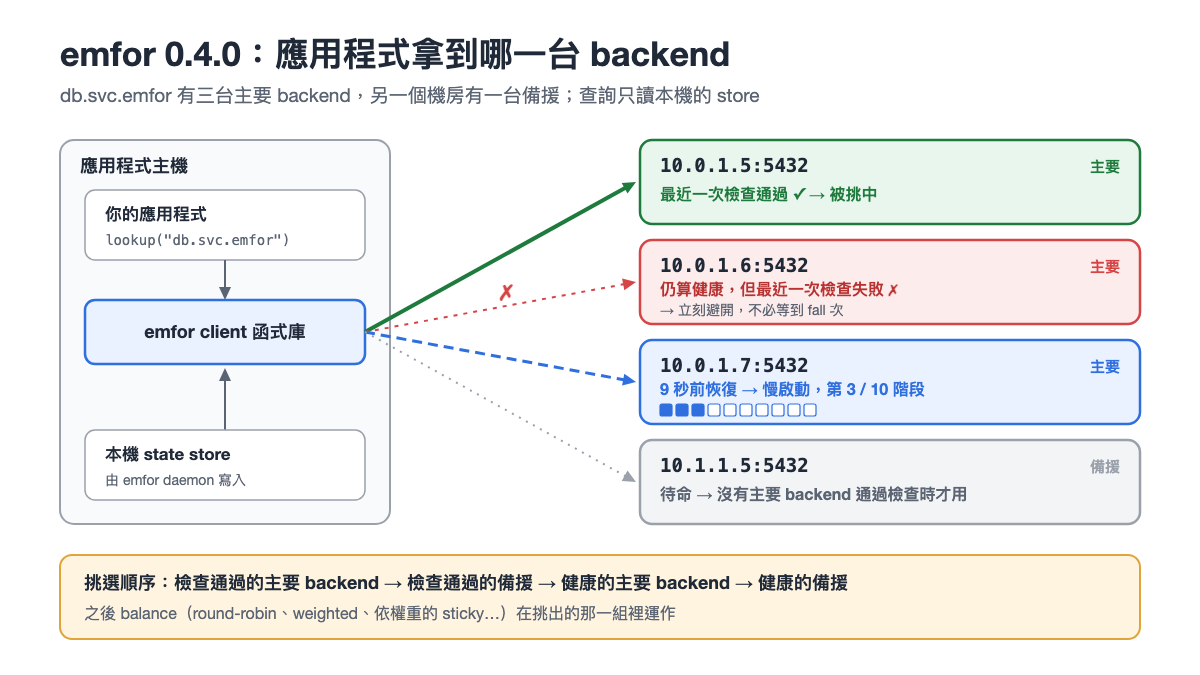
emfor 是一個開源、跑在每一台應用程式主機上的健康檢查 daemon:它檢查應用程式所用服務的 backend,把哪些 backend 健康寫進本機的檔案,應用程式透過 client 函式庫在大約一微秒內查到該連哪一台,不經過網路。
0.4.0 在 2026-11-14 發佈。這一版的重點在於應用程式拿到的那個位址:什麼時候該用備援、剛恢復的 backend 要不要馬上接滿流量、一個 backend 開始出問題時要多快避開它。另外,聯防群組的訊息改為加密,emfor-check 也多了五種協定。
一、升級前先看:三項不相容的變更
1. store 格式升到第 2 版。 daemon 寫入的 meta/schema_version 變成 2,多了 backend 的 backup 欄位。0.4.0 的 client 與 emfor status 讀得懂第 1、2 版;較舊的 client 碰到第 2 版的 store,每次查詢都會回 INCOMPATIBLE。所以先升級主機上的 client(libemfor 與各語言的套件),再升級 daemon。
2. 聯防群組的訊息預設加密。 還在跑 0.3.0 的成員讀不懂,會把它們當成 malformed 丟掉。逐台升級時,先在每台升級的主機的 [peers] 加上 encrypt = false;等每個成員都升到 0.4.0,再拿掉這一行並 reload。
3. FreeBSD:examples/rc.d/emfor 拿掉了。 現在只剩 port 裡的 examples/freebsd/files/emfor.in 這一份 rc.d script;不透過 port 安裝的人,照手冊第 2 章把 %%PREFIX%% 換掉後安裝。它的 emfor_user 預設是 emfor,不再是 root。另外,範例 port 把 store 放在 FreeBSD 慣用的 /var/db/emfor,主機上的應用程式要設 EMFOR_STORE=/var/db/emfor/state.mdb。
二、挑 backend:更謹慎地決定要連哪一台
備援 backend
backend 可以標成備援:
[services."db.svc.emfor"]
check = "tcp"
balance = "failover"
backends = [
  "10.0.1.5:5432",
  "10.0.1.6:5432",
  { addr = "10.1.1.5:5432", backup = true },   # 另一個機房
]
只要還有任何一台非備援的 backend 通過檢查,備援就不會被用到。挑選順序是:最近一次檢查通過的主要 backend → 最近一次檢查通過的備援 → 健康的主要 backend → 健康的備援;balance 在挑出的那一組裡運作。典型用法是把另一個機房、或比較貴的 backend 設成備援。DNS 的 SRV 回答也只列出挑出的那一組。
檢查一失敗就先避開
一台 backend 要連續失敗 fall 次才會變成 unhealthy,預設大約 6 秒。在這之前它仍算健康,0.3.0 的應用程式會繼續連過去。
0.4.0 的 client 與 DNS 伺服器會先避開「仍算健康、但最近一次檢查失敗」的 backend,只要還有其他健康的 backend 最近一次檢查通過。也就是說,backend 在第一次檢查失敗時就不再被挑中,不用等到 fall 次;它的狀態仍照 rise / fall 計算,恢復後自然回來。如果每台健康的 backend 都在失敗,就照舊全部使用,不會因此全部拒絕。
on_all_down = "open" 而且沒有任何健康的 backend 時,也有類似的調整:先用還沒判定、或檢查只回錯誤的 unknown backend,最後才用確定失敗的 unhealthy 那些。
慢啟動
剛從 unhealthy 恢復的 backend,快取是冷的、連線池是空的,一下子接滿流量常常又被打掛。新的 slow_start 讓它在一段時間內分 10 個階段逐步拿到完整的流量比例:
[defaults]
slow_start = "30s"     # 預設 "0s",關閉
它作用於 client 查詢與 DNS 的 A / AAAA 回答(failover 與帶 key 的 sticky 除外),以及 SRV 的權重。
sticky 也看權重
balance = "sticky" 帶 affinity key 時,現在會依 weight 分配:權重 w 的 backend 拿到 w 份的 key。計算只用整數與 MD5,每台主機、每種語言的 client 對同一個 key 仍挑出同一台。所有權重都是 1 時結果不變;已經設了其他權重的 sticky 服務,升級 client 後會有一部分 key 換到別台,同一個服務的 client 最好一起升級。
三、聯防群組
訊息加密。 0.3.0 的聯防訊息有簽章但是明文,backend 名稱、位址與錯誤原因都看得到。0.4.0 改為 EMP2:以 HKDF-SHA256 從 secret_file 推導金鑰、ChaCha20-Poly1305 加密,每則訊息用隨機 nonce。更換密鑰的方式和以前一樣。這個設計沒有 forward secrecy:日後拿到密鑰的人,可以解開之前錄下的訊息,所以密鑰要定期更換。
只有非負責主機看到的故障,發現得更快。 0.3.0 的已知限制是:只有某台非負責主機看得到的故障,最多要大約五個 interval 加上 fall 次檢查才會發現。0.4.0 的非負責主機至少每三個 interval 自己檢查一次;而且當它自己的檢查失敗、但負責主機都說 up 時,會像收到其他成員的 down 通知一樣,開始每 200 ms 一次、最多 fall 次的快速複查。以 interval = "2s"、fall = 3 實測 12 次故障,這台主機判定 down 花了 0.8 到 5.8 秒,中位數 3.3 秒;0.3.0 依排程估算最長約 14 秒。代價是每個 backend 每個 interval 的檢查次數,從 3 + (N − 3) / 5 變成 3 + (N − 3) / 3。
四、emfor-check:五個新 plugin
emfor-check 是隨 emfor 發佈的 plugin,用來檢查需要懂協定的服務。0.4.0 新增:
| plugin | 檢查內容 |
|---|---|
smtp | 220 greeting 與 EHLO,可加 STARTTLS 或 465 port 的 TLS;不登入、不寄信 |
amqp | AMQP 0-9-1(如 RabbitMQ):PLAIN 登入並開啟 vhost |
mongodb | MongoDB 4.4 以上的 hello,可選 SCRAM-SHA-256 登入;role = "primary" 讓 failover 跟著 replica set 的 primary 走 |
grpc | 標準 grpc.health.v1.Health/Check,回 SERVING 才算 up |
quic | QUIC version 1 握手;http3 = true 時再送 HTTP/3 GET,像內建的 http 檢查一樣看 status 與 body |
資料庫的檢查也更嚴格:role = "replica" 現在表示正在複寫的 replica——redis 與 master 的連線是 connected、MySQL / MariaDB 的 IO 與 SQL thread 都在跑、PostgreSQL standby 有 WAL receiver;搭配 max_lag 可以限制 replica 落後的秒數。注意:0.3.0 時,複寫中斷但 role = "replica" 仍算 up 的 redis replica,在 0.4.0 會變成 down。
LDAP 的錯誤原因對 Active Directory 也更好讀了:AD 在診斷訊息尾端加的 NUL 字元會被去掉;伺服器在 TLS 握手時直接斷線(AD 沒有 LDAPS 憑證時就是這樣),原因會寫成 tls: connection closed during the TLS handshake (does the server have a certificate?)。
五、其他改變
- 內建的
http檢查新增expect_body:回應內容必須包含指定文字,適合不管狀態如何都回 200 的健康檢查端點。 - macOS 上,
exec檢查與 plugin 不再繼承 daemon 的 socket 與 pipe。 - FreeBSD:rc.d script 以
daemon(8) -f啟動,執行service emfor start的 SSH session 不會再卡住。daemon、rc.d script、port 與測試第一次在 FreeBSD 15.1-RELEASE(arm64)上完整跑過。 - 每個 fuzz target 在發版前各跑 10 分鐘。0.4.0 的 plugin 回應、聯防訊息、metrics、plugin 協定與設定檔五個 target,合計跑了約 1,800 萬次,沒有 crash。
- 使用手冊現在也放在這個網站上:emfor 使用手冊。
六、已知限制
- FreeBSD 只在 15.1-RELEASE arm64 上測過;poudriere、14.x 與 amd64 還沒有。
ldapplugin 對 Active Directory 只測過沒有憑證、沒有成功登入的情況;mysqlplugin 發佈時只對 MariaDB 測過(發佈後補測:MySQL 8.0 與 8.4 也都通過)。[store] sync = false(預設)時,主機當機可能讓 store 損壞;daemon 下次啟動會把它移到一旁,狀態歷史會遺失。手冊第 8 章說明了怎麼把 store 放在 tmpfs 上。
七、怎麼升級
- 在每台主機先升級 client:
libemfor與各語言的套件都要來自 0.4.0。 - 逐台升級 daemon 並重新啟動。有聯防群組的話,升級每台時在它的
[peers]加上encrypt = false(0.3.0 不認得這個設定,所以不要事先加)。 - 群組裡每台都是 0.4.0 之後,拿掉
encrypt = false,逐台 reload。
完整的變更紀錄在 CHANGELOG,原始碼在 GitHub 的 v0.4.0 release。
💡 技術協作與架構諮詢
您的服務是否也面臨健康檢查不一致、故障發現太慢,或檢查流量壓垮 backend 的問題? 我們能協助您評估架構、導入合適的健康檢查與服務發現機制。